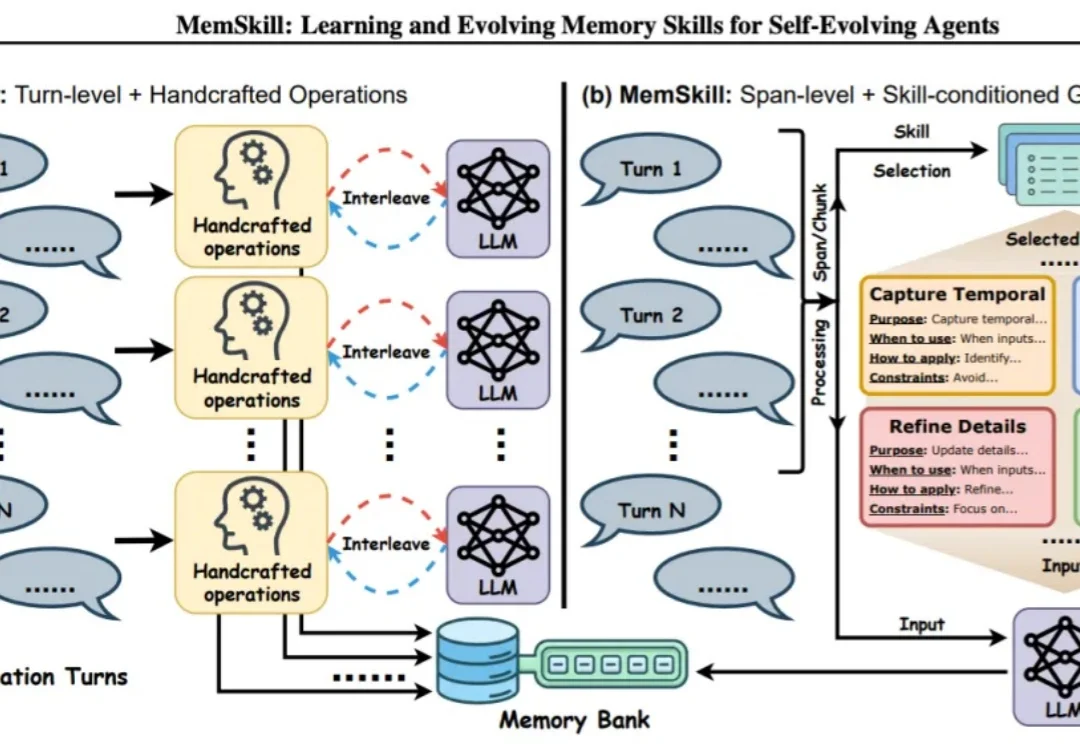
NeurIPS 2026|MemSkill让智能体学习并进化记忆技能
NeurIPS 2026|MemSkill让智能体学习并进化记忆技能随着递归自我改进(Recursive Self-Improvement,RSI)受到关注,智能体如何从交互经验中持续改进自身成为研究热点。智能体记忆机制影响着这些经验能否被有效保留和利用。
来自主题: AI技术研报
8411 点击 2026-11-03 10:40

 搜索
随着递归自我改进(Recursive Self-Improvement,RSI)受到关注,智能体如何从交互经验中持续改进自身成为研究热点。智能体记忆机制影响着这些经验能否被有效保留和利用。
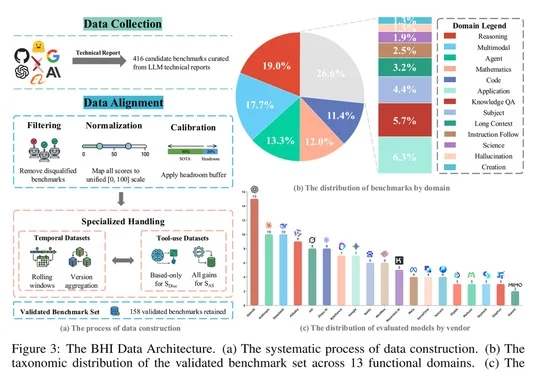
阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。
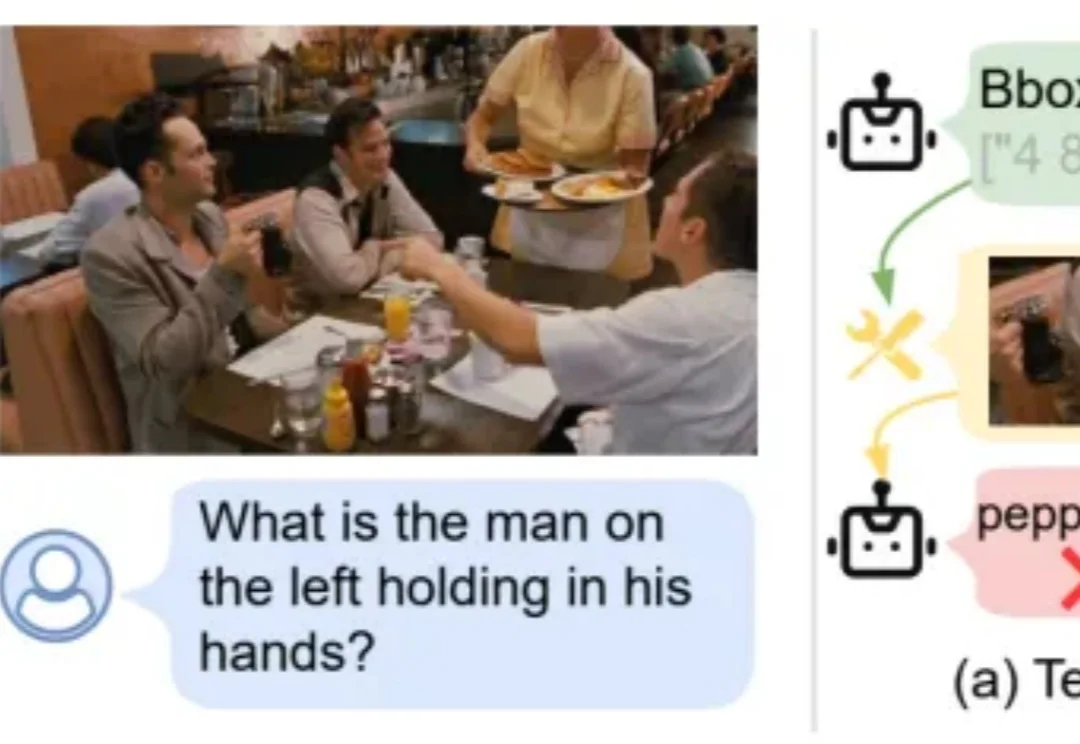
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?
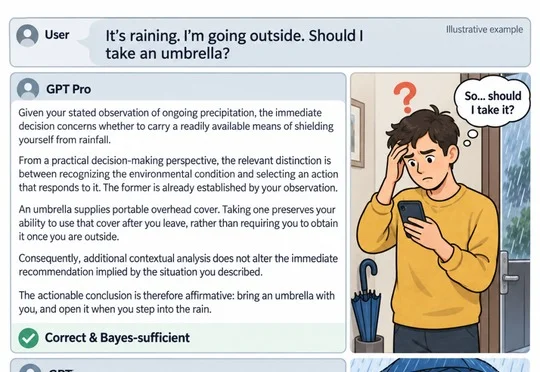
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
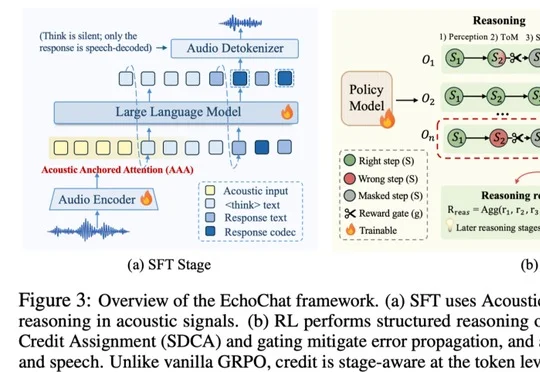
EchoChat将共情语音对话拆分为感知、心智理论推理和回复生成,并通过Acoustic-Anchored Attention与Step-Decomposed Credit Assignment统一优化,在三项评测中取得领先表现。
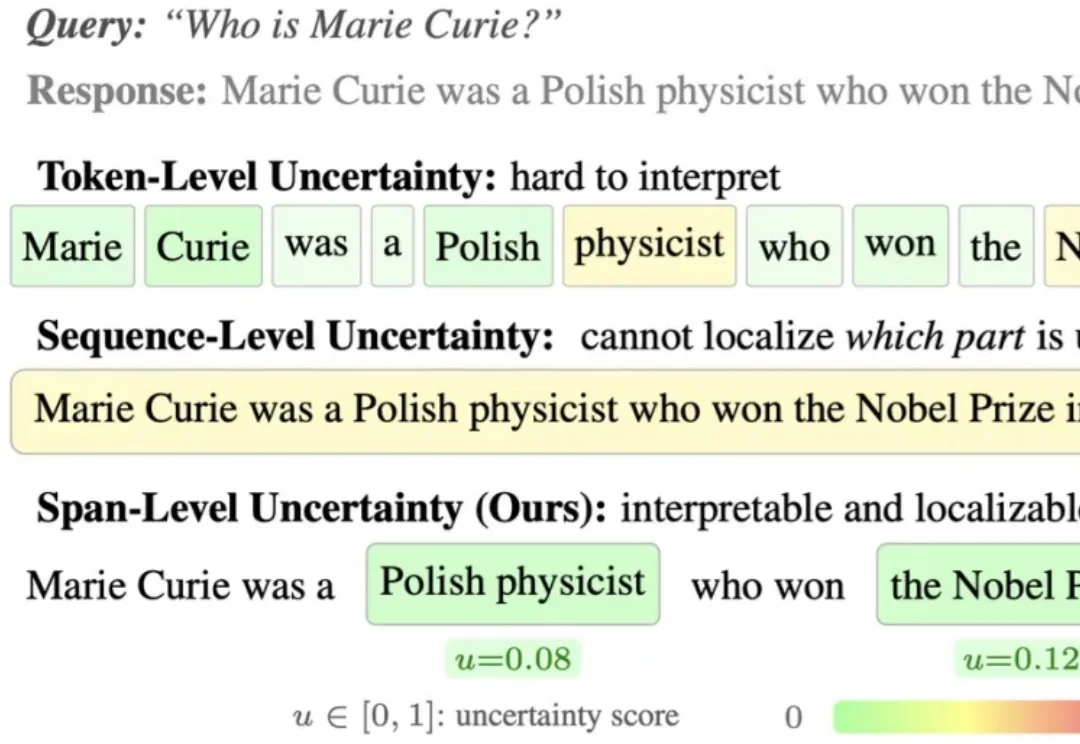
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
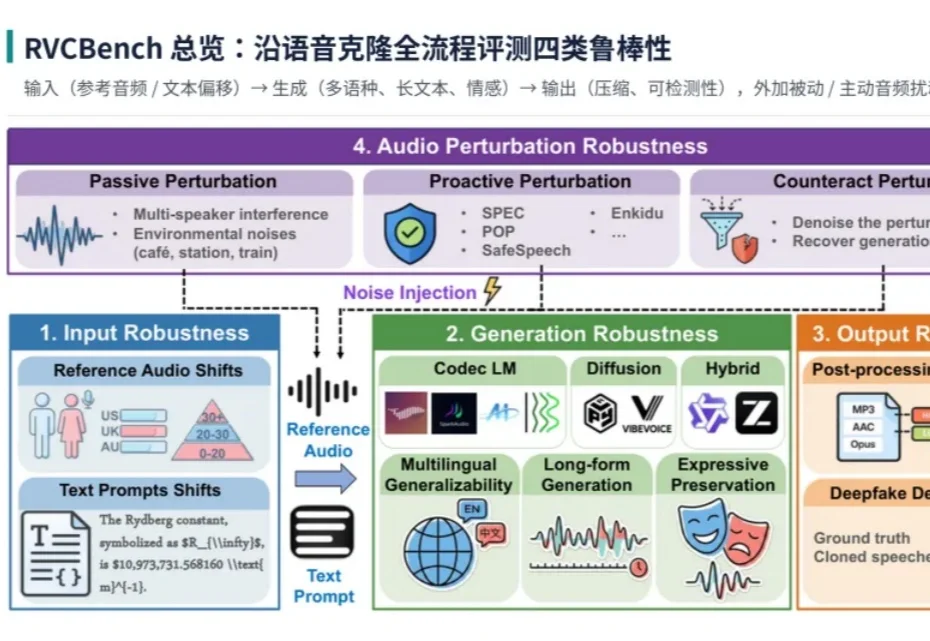
导读:只需几秒参考音频,现代语音克隆模型就能合成与目标说话人高度相似的语音。但真实部署中的参考录音往往带有噪声,文本可能异常、超长或跨语言,生成的语音还要经过压缩和电话传输,有人甚至会给自己的声音加上「防克隆」保护。
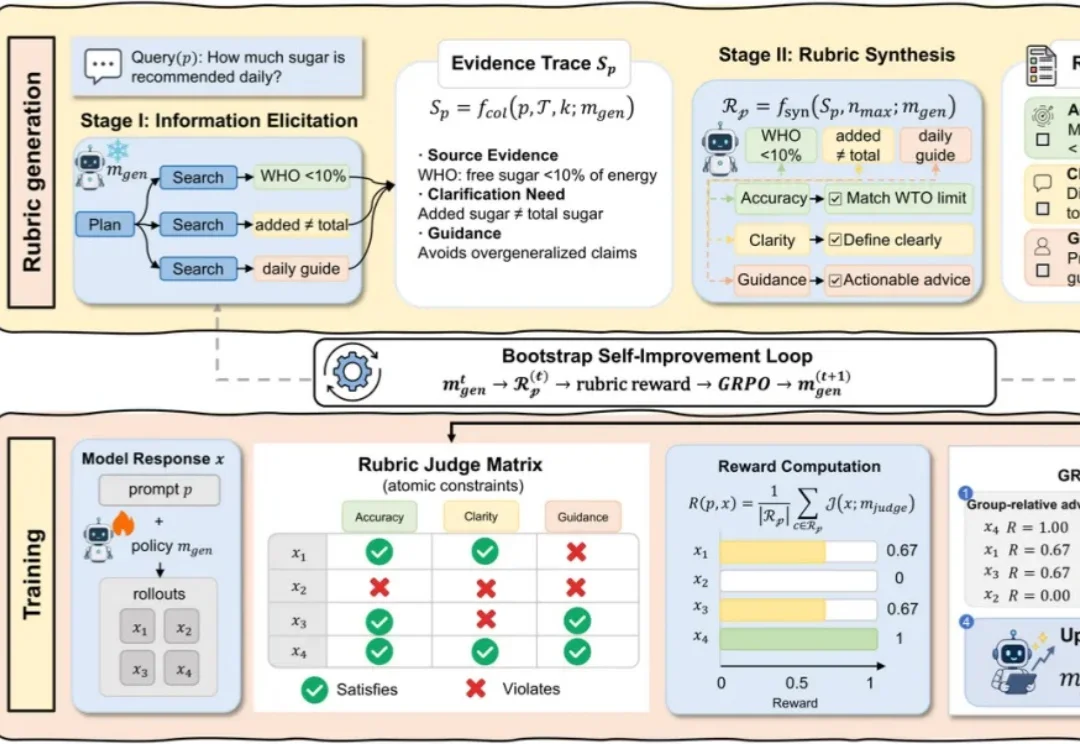
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
厦门大学ASC Lab团队提出的FlowMAS获NeurIPS 2026录用,通过GFlowNet、好奇心驱动模块和信息引导优化模块自动生成多样且低成本的大模型多智能体工作流拓扑,并在六个基准实验中取得领先成绩。
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。